La IA promete salvar vidas – pero no cumple lo que sugieren los titulares
La IA promete salvar vidas en la sanidad – pero aún no entrega resultados en la práctica.

Análisis de imágenes y diagnóstico precoz: Las promesas son reales
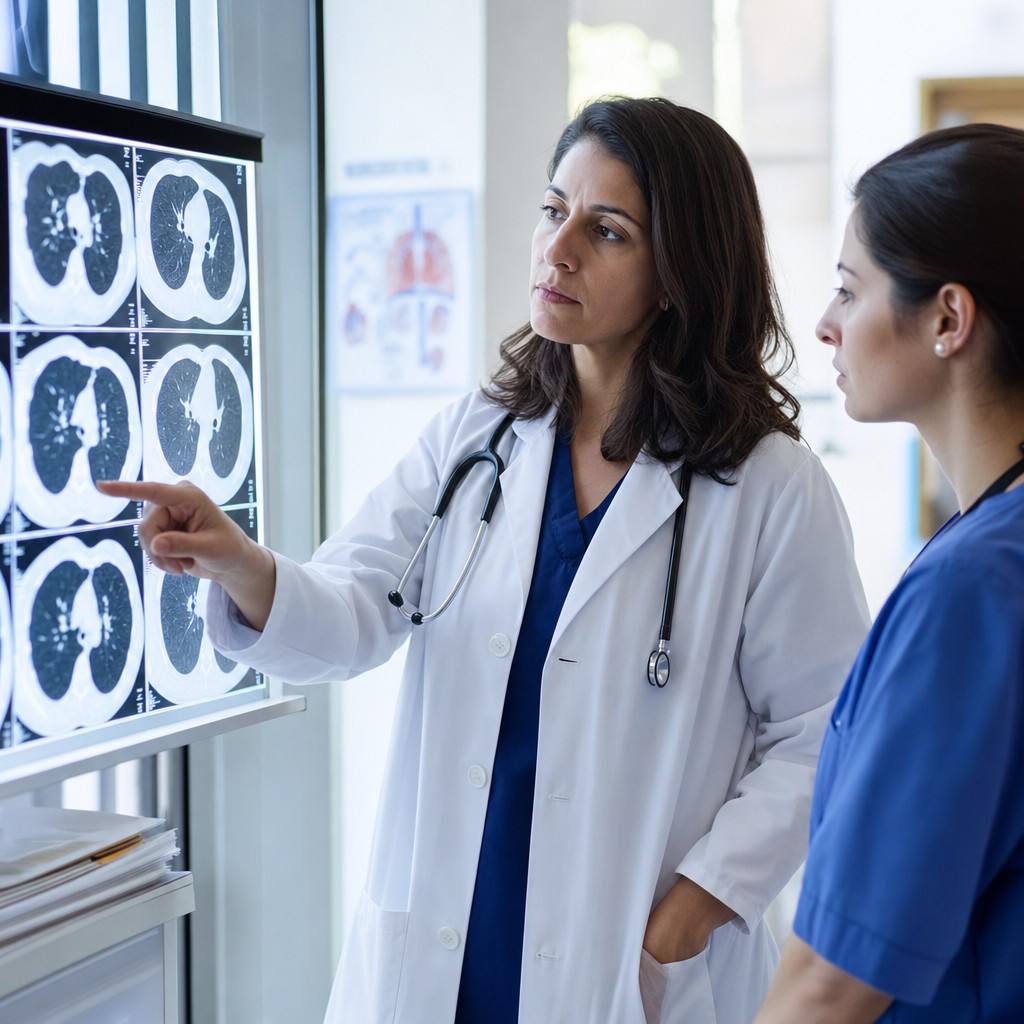
Comencemos donde la esperanza es mayor. Una revisión bibliográfica exhaustiva publicada en arXiv examina 96 estudios científicos sobre IA y diagnóstico de cáncer de pulmón desde 2015 en adelante. La conclusión es clara: las redes convolucionales con aprendizaje por transferencia y aumento de datos logran alta precisión en el análisis de imágenes radiológicas y tomografías computarizadas. Se trata de una forma de cáncer que mata a cientos de miles de personas cada año, y donde el diagnóstico precoz es literalmente la diferencia entre la vida y la muerte.
Pero el estudio no se detiene en los aplausos. Los investigadores señalan un conjunto bien conocido de obstáculos: falta de conjuntos de datos estandarizados, dificultades para explicar cómo razonan realmente los modelos, y cuestiones sin resolver en torno a la privacidad y la ética. Son obstáculos que ya hemos escuchado antes – y ese es precisamente el problema. Siguen siendo irresueltos.
Calcula bien, ¿pero por las razones equivocadas?
Otro estudio adopta un enfoque más quirúrgico sobre una debilidad específica de los grandes modelos de lenguaje: la aritmética. En los sistemas de apoyo a decisiones clínicas, un único error de cálculo puede cambiar una recomendación médica. La solución que prueban los investigadores es elegante en su sencillez – en lugar de dejar que el modelo calcule, se le permite escribir código Python que luego se ejecuta en un entorno controlado y determinista. El modelo decide cómo debe realizarse el cálculo; la máquina lo ejecuta.
Probado en el estándar de referencia MedCalc-Bench con 1 100 casos clínicos, el método mostró una mejora clara para el modelo más grande de 32 mil millones de parámetros, pero los resultados para la variante más pequeña de 7 mil millones fueron más inciertos. Los investigadores son cuidadosos en señalar que el método no lo resuelve todo – fórmulas médicas verificadas y extracción confiable de variables de los registros del paciente siguen siendo requisitos previos.
Es un recordatorio importante: la IA puede ser buena resolviendo un subproblema sin que toda la cadena funcione.
¿Suficientemente estable para un quirófano?
En el lado más técnico de sistemas, se presenta SurgialRoomAgent, un sistema multinivel controlado por voz para quirófanos basado en el modelo de lenguaje Qwen3-27B. El sistema maneja control de equipos, documentación automática y generación de reportes – todo mediante voz. Se han desarrollado tres soluciones técnicas para reducir los tiempos de respuesta a niveles aceptables para uso en tiempo real: precalentamiento de caché de memoria, interpretación basada en flujo de datos estructurados y filtrado dinámico según el rol del usuario y la fase quirúrgica.
Suena impresionante. Pero un estudio paralelo arroja sombra sobre la imagen de agentes de IA en entornos críticos. Los investigadores simularon 120 escenarios de atención médica y encontraron que los agentes bajo carga creciente se vuelven cada vez más dependientes de la ayuda humana – y que reportan alta carga de trabajo en sus registros estructurados, pero rara vez lo indican en sus respuestas de texto habitual. Esto significa que un operador que solo lee el flujo de conversación puede perder que el sistema está a punto de colapsar.
Es un problema sutil pero grave.
Contexto cultural y salud mental
A nivel internacional también hay trabajo interesante en curso que desafía la suposición de que las herramientas de IA para la salud pueden ser universales. Un equipo de investigadores presenta una herramienta de apoyo para la salud mental dirigida a estudiantes universitarios pakistaníes, entrenada con respuestas de 1 100 estudiantes. El sistema clasifica niveles de estrés con un 89 por ciento de precisión y mantiene conversaciones culturalmente adaptadas en inglés, urdu y urdu romano.
Una observación destaca: la relación profesor-estudiante resultó ser el segundo factor de estrés más importante – una dinámica culturalmente específica que un sistema occidental probablemente habría pasado por alto. Recuerda que los desafíos de la medicina basada en IA no son solo técnicos, sino también geográficos y culturales.
Estándares de referencia que mantienen la perspectiva
En medio de todo esto se lanza PhenoBench, un estándar de referencia abierto y ejecutable construido con datos de más de 13 000 participantes y 90 tareas con anclaje clínico. El propósito es dar al campo una medida común – algo que ha faltado durante mucho tiempo. Los resultados muestran que los nuevos modelos base para datos tabulares ciertamente funcionan algo mejor que los modelos tradicionales, pero el margen es pequeño. Y los grandes modelos de lenguaje, a pesar de su amplitud, rara vez superan a los modelos especializados en tareas clínicas específicas.
Es una imagen sobria pero necesaria para mantenerse cuando el entusiasmo tiende a dispararse.