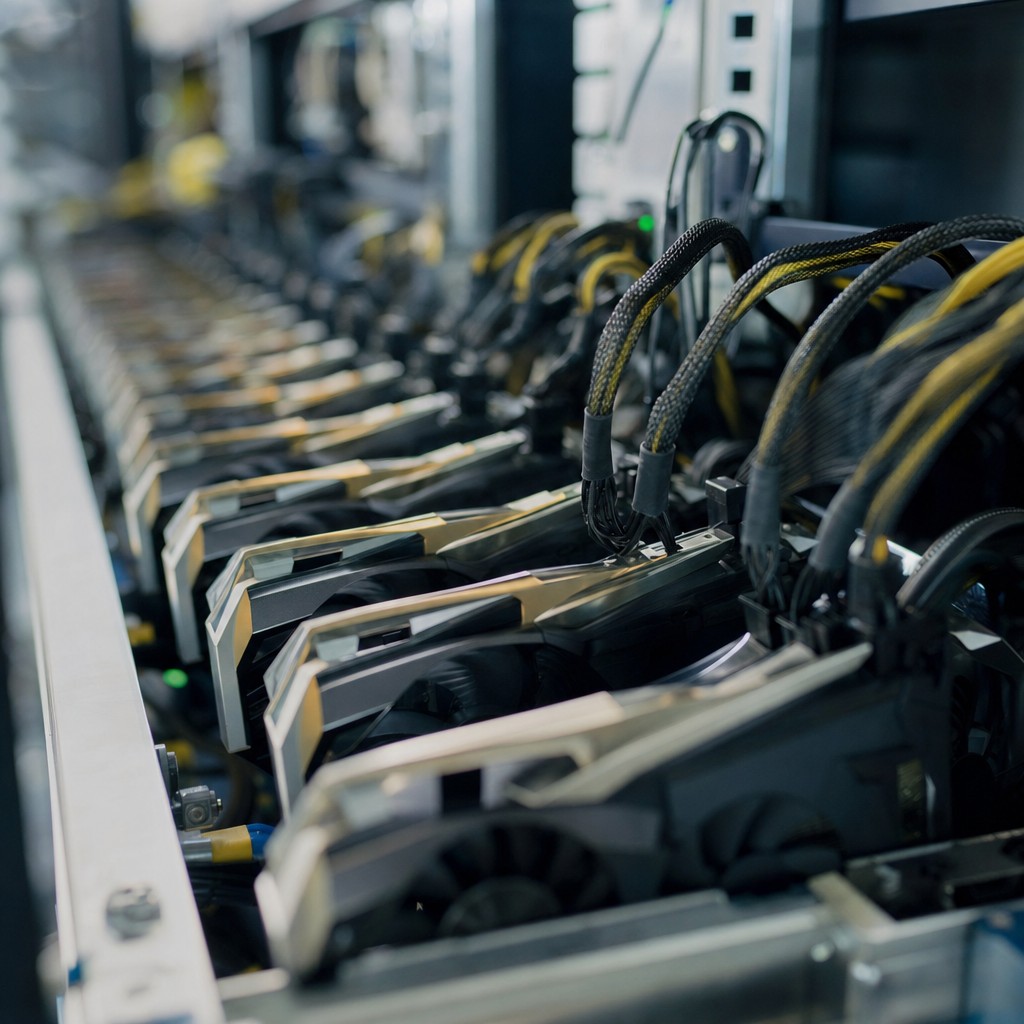
La tarjeta gráfica se hace cargo del entrenamiento de robots – miles de simulaciones se ejecutan ahora en paralelo
El nuevo marco de trabajo de NVIDIA permite que 2 048 robots entrenen simultáneamente en una única tarjeta gráfica.

El cuello de botella del que nadie hablaba
Existe una pregunta que ha permanecido en segundo plano cuando los desarrolladores de robots han discutido sobre la velocidad de entrenamiento: ¿Qué tan rápido puede ejecutarse una simulación individual? Pero según el blog de Hugging Face, esa pregunta ha dejado de ser relevante en la práctica. La pregunta pertinente hoy es otra – ¿cuántas simulaciones pueden ejecutarse simultáneamente?
Es un cambio sutil pero decisivo. La simulación tradicional de robots con la popular herramienta MuJoCo se ha basado en potencia de procesador, y ciertamente el trabajo puede distribuirse entre múltiples núcleos de procesador. Pero cuando los volúmenes de datos del aprendizaje automático moderno crecen, simplemente no es suficiente. Cada paso de entrenamiento requiere millones de experiencias, y recopilarlas una a una – o incluso por docenas – crea un cuello de botella que ralentiza todo el desarrollo.
La tarjeta gráfica asume el rol de simulación
Es aquí donde entra el marco de trabajo Warp de NVIDIA. Warp es un marco de trabajo basado en Python para computación de alto rendimiento en tarjetas gráficas. Lo que lo hace particularmente interesante es que los desarrolladores escriben kernels con tipos estáticos en sintaxis Python ordinaria, que luego se compilan para ejecución en CUDA. La primera vez que se inicia un kernel, el código se compila y se guarda – después se reutiliza directamente, sin sobrecarga.
Sobre Warp, NVIDIA ha construido MuJoCo Warp, frecuentemente abreviado como MJWarp. Toma modelos existentes de MuJoCo – las simulaciones de física que los investigadores de robótica ya usan y en las que confían – y los escala a la capacidad de tarjeta gráfica. El resultado es espectacular: en el ejemplo descrito en el artículo fuente, se pueden ejecutar hasta 2 048 entornos de simulación en paralelo para un brazo robótico del modelo SO-101, todo en una única tarjeta gráfica.
Un principio de diseño central hace esto posible: cada hilo lógico maneja exactamente un objeto – un punto, una superficie de contacto, un cuerpo o un mundo completamente simulado. Esto significa que miles de robots simulados literalmente viven sus propias vidas en paralelo, recopilan experiencias, fallan, se ajustan – y aprenden.
Lo que significa en la práctica
Para entender por qué esto es significativo, ayuda pensar en cómo los robots modernos realmente aprenden. El aprendizaje por refuerzo – el método que domina gran parte del entrenamiento de robots hoy – requiere enormes cantidades de retroalimentación. Un robot debe probar miles de variantes de un movimiento, recibir retroalimentación sobre cuáles funcionaron, e iterar. Es consustancial a su definición que sea que requiera tiempo.
Cuando el entrenamiento que anteriormente tomaba días o meses puede comprimirse en horas, se abren posibilidades que antes eran impracticables. Los investigadores pueden probar más hipótesis. Las empresas pueden iterar más rápido. Y – quizás lo más importante – la barrera de entrada para entrenar robots especializados para aplicaciones específicas desciende notablemente.
No es una promesa hipotética. La simulación acelerada por tarjeta gráfica es un patrón que hemos visto crecer en varios campos – desde simulación de fluidos en gráficos de videojuegos hasta química computacional – y cada vez los aumentos de velocidad han permitido saltos cualitativos, no solo cuantitativos.
Ecosistema abierto como catalizador
Un detalle que merece atención: MJWarp se construye sobre modelos existentes de MuJoCo, lo que significa que la gran colección de modelos de robots ya creados y entornos de investigación pueden usarse directamente. Esto reduce significativamente el costo de entrada. Los grupos de investigación y pequeñas empresas no necesitan reconstruir desde cero – pueden tomar sus simulaciones existentes y escalarlas.
El compromiso de Hugging Face en difundir el conocimiento sobre la tecnología también sugiere que esto no es una solución cerrada interna de NVIDIA, sino algo pensado para vivir en un ecosistema más amplio y abierto. Es una señal importante de cómo la tecnología realmente se distribuirá y utilizará.