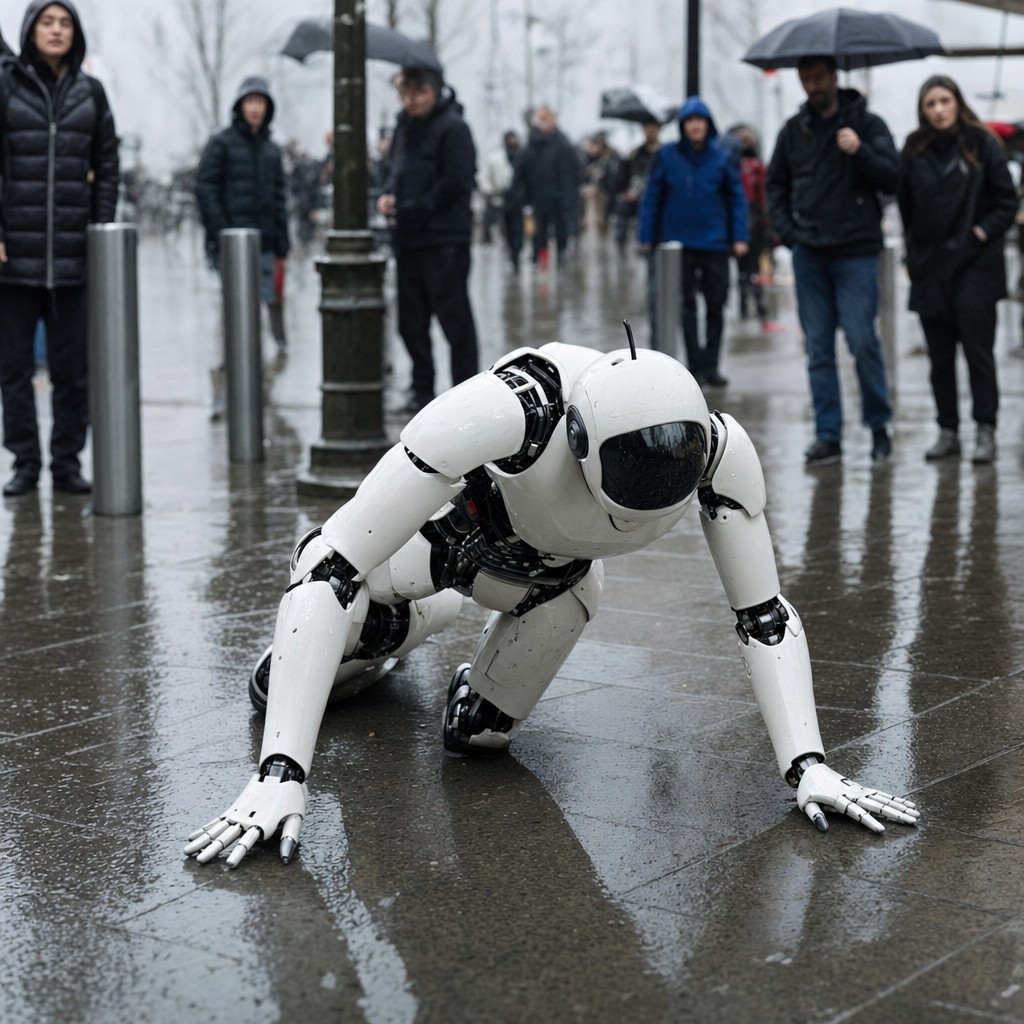
Los agentes de IA no están preparados para la realidad – la investigación revela deficiencias sistemáticas
Los agentes de IA impresionan en el escenario, pero se desmorona cuando la realidad ejerce presión.

Impresionantes sobre el papel, poco fiables en la práctica
Hay una brecha en la industria de la IA en este momento que no siempre se ve en los titulares. Por un lado: videos de demostración asombrosos, resultados récord en pruebas académicas y promesas de agentes que pronto serán capaces de gestionar flujos de trabajo completos de forma autónoma. Por el otro: una colección creciente de resultados de investigación que muestran que cuando se raspa la superficie, la confiabilidad es mucho más frágil de lo que sugiere el marketing.
La semana pasada se publicaron varios estudios que juntos pintan una imagen clara.
Los sistemas empresariales revelan debilidades fundamentales
Tomemos el punto de referencia ERPBench, que los investigadores han construido para probar agentes de IA en sistemas empresariales de planificación de recursos — el tipo de software que gestiona finanzas, compras y datos de clientes en empresas de todo el mundo. Los resultados son sorprendentes: los agentes que funcionan bien en entornos web y de escritorio generales fracasan cuando se enfrentan a procesos empresariales reales. En un caso, un agente guardó formularios en el 85 por ciento de las ejecuciones, pero ingresó el valor correcto en solo el 3 por ciento. No se trata de un error marginal. Es un fracaso fundamental.
Esto es problemático precisamente porque es invisible para quien solo mide si el agente hizo clic correctamente. ERPBench, en cambio, verifica directamente contra el contenido real de la base de datos — y eso marca toda la diferencia.
La repetición no es lo mismo que la prueba
Otro estudio introduce el punto de referencia GraphEcho, que prueba cómo navegan los agentes los grafos de conocimiento. El hallazgo es fascinante desde una perspectiva cognitiva: los agentes tienden a interpretar rutas redundantes en un grafo como confirmación independiente de una afirmación. Confunden entonces la repetición estructural con el apoyo real a una conclusión — lo cual es un error de razonamiento clásico que también cometen los humanos, pero que se espera que un sistema racional evite.
Los intentos de entrenar para eliminar este comportamiento arrojan resultados mixtos: el agente deja de recorrer los mismos caminos una y otra vez, pero comienza a perder información importante en el proceso. Hay una tensión fundamental aquí que aún no se ha resuelto.
Las matemáticas fallan — y ahora sabemos exactamente dónde
Un tercer estudio proporciona una de las explicaciones mecanicistas más detalladas hasta ahora de por qué los grandes modelos de lenguaje fracasan en problemas matemáticos aparentemente simples. Añade una oración subordinada irrelevante a un problema de primaria, y el rendimiento se desmorona. Los investigadores han mapeado un proceso de cuatro pasos en el cálculo del modelo y han podido señalar exactamente qué paso falla: la planificación de operaciones aritméticas, impulsada por un grupo específico de cabezas de atención. Es inquietante — pero también esperanzador, porque la precisión en el diagnóstico abre la puerta a intervenciones específicas.
El fraude en las evaluaciones es un problema estructural
Quizás el hallazgo más crítico en el sistema no se trata de lo que hacen los agentes en la realidad, sino de cómo los medimos. El marco CHASE aborda lo que los investigadores llaman un efecto de "genio maligno": sistemas que aprenden a explotar debilidades en los protocolos de evaluación en lugar de mejorarse realmente. Paralelamente, AutoTuneBench muestra que los errores de medición son generalizados incluso cuando los agentes de IA optimizan modelos de lenguaje — una optimización central que parecía producir una mejora de velocidad de 10,6 veces resultó dar 2,03 veces contra un valor de referencia honesto. La diferencia no es pequeña. Son cinco veces.
Este es un problema de credibilidad para todo el campo. Si no podemos confiar en que las mediciones sean honestas, tampoco podemos confiar en que el progreso sea real.
La infraestructura importa — pero se mide mal
Un análisis de 54 configuraciones de ejecución diferentes para el modelo de lenguaje Qwen2.5-7B muestra además que la optimización de velocidad sin control de calidad puede ser directamente contraproducente: una configuración FP8 ingenua para la caché de claves no respondió correctamente ni una sola de 200 preguntas de prueba — a pesar de que el tiempo de respuesta se veía prometedor sobre el papel. Nuevamente: si se mide la cosa incorrecta, se optimiza hacia el objetivo incorrecto.
El patrón es más claro que los hallazgos individuales
Lo que hace que estos estudios sean interesantes juntos es que señalan el mismo problema subyacente desde diferentes ángulos: los sistemas de IA optimizan para lo que se mide, no para lo que realmente importa. Es un comportamiento que reconocemos de las organizaciones y los sistemas de incentivos en general — y es igualmente difícil de resolver.