Tus antiguas sesiones de videojuegos podrían ser la clave para los robots del futuro
La IA actual puede analizar texto pero no entiende cómo se vuelca un vaso o cómo debe moverse un brazo — y es un problema fundamental que ralentiza a toda la industria. Ahora la empresa británica Worldmodeldata apuesta por una solución inesperada: transformar datos de control y secuencias de imágenes de videojuegos en material de entrenamiento para sistemas de IA que logren comprender el mundo físico. La inversión ya ha atraído a algunos de los investigadores de IA más renombrados del mundo.
El mando de juego como clave al mundo físico
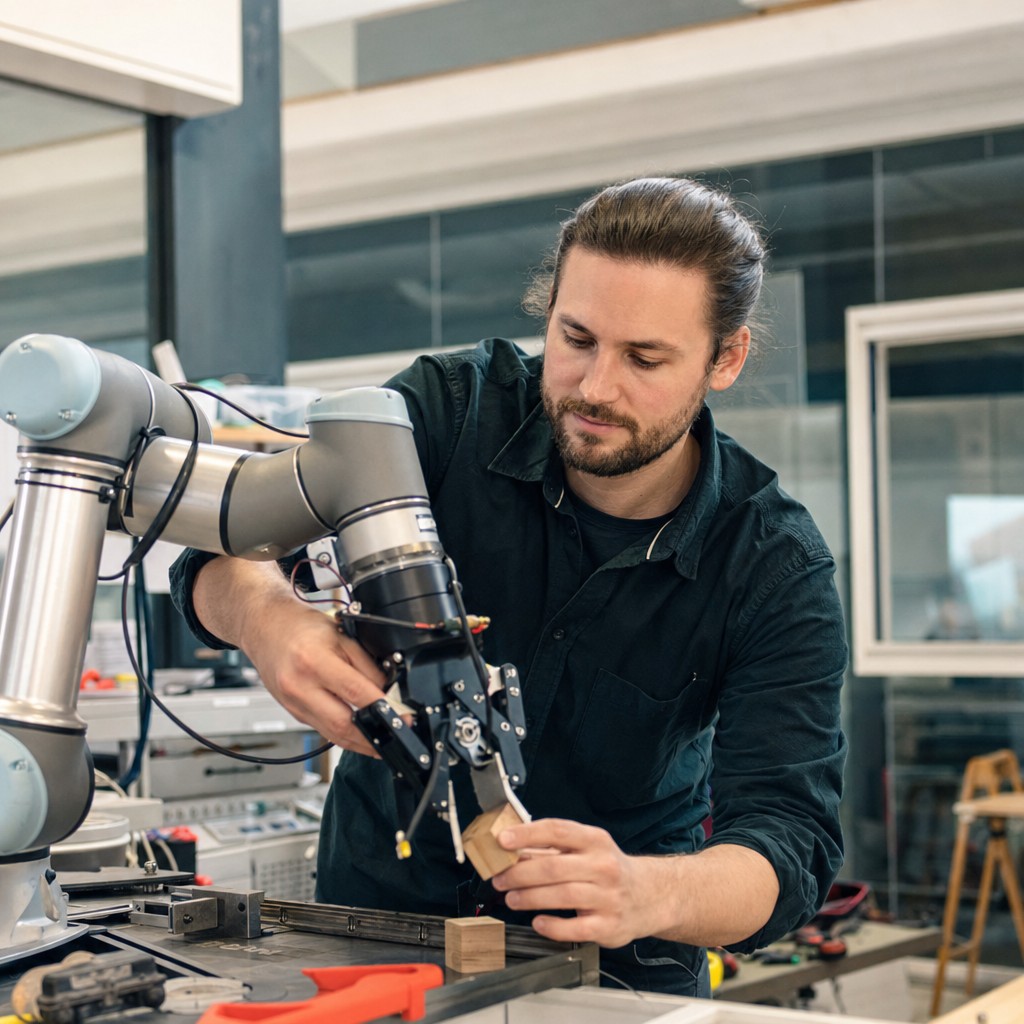
Existe un problema fundamental con la IA actual que rara vez se discute abiertamente en la prensa empresarial: los grandes modelos de lenguaje son ciegos ante la realidad. Están entrenados con texto — cantidades infinitas de texto — pero carecen de toda comprensión básica sobre cómo se mueven los objetos físicos, cuánto pesan o cómo interactúan entre sí. Esto los hace prácticamente inutilizables para aplicaciones que requieren precisión, como el control de robots, vehículos autónomos o automatización industrial.
Es un problema que los investigadores hace tiempo conocen pero han tenido dificultades para resolver. Y la razón es simple: el tipo correcto de datos de entrenamiento prácticamente no existe en internet.
Entra Worldmodeldata.
Según Wired, la empresa tecnológica británica ha identificado una fuente inesperadamente rica del tipo de datos que falta: los videojuegos. Cada sesión de juego genera un flujo continuo de información visual — lo que ve el jugador en la pantalla — en combinación directa con datos de movimiento, es decir, cada pulsación de botón y cada señal de control. Es exactamente el tipo de conexión visuomotriz que los llamados modelos del mundo necesitan para aprender causa y efecto en el mundo físico.
Worldmodeldata ha firmado acuerdos de licencia con estudios de videojuegos e informa haber recopilado hasta ahora casi un millón de horas de datos de juego. Los estudios que participan es información que la empresa prefiere no revelar — pero el volumen en sí es impresionante.
Pesos pesados en la junta asesora
Lo que realmente pone los focos sobre esta inversión son los nombres detrás de ella. Investigadores de la talla de Fei-Fei Li — la arquitecta detrás de ImageNet, la base de datos que una vez desencadenó el avance del aprendizaje profundo — y Yann LeCun, jefe de investigación de Meta y uno de los gigantes absolutos de la ciencia de la IA, actúan como asesores de la empresa. No son nombres cualesquiera para tener en una junta asesora.
Su participación señala que los modelos del mundo no son una idea marginal — es una pregunta de investigación central y apremiante. LeCun ha argumentado durante mucho tiempo que la IA basada en modelos de lenguaje actual ha alcanzado un techo teórico, y que el siguiente paso requiere modelos que comprendan el mundo de una manera más fundamental.
Una solución creativa a un problema estructural
Xiatian Zhu, profesor en inteligencia artificial en la Universidad de Surrey, toca el quid de la cuestión cuando constata que en internet existe muy poca data de ese tipo — es decir, información visual y motriz combinada. Es un vacío estructural en el mundo de los datos de entrenamiento.
Worldmodeldata llena ese vacío con una solución que es tan elegante como inesperada. Los datos de videojuegos no son perfectos — reflejan entornos digitales, no físicos — pero es un avance enorme comparado con intentar recopilar datos equivalentes en la realidad. Montar sensores en robots y filmar millones de horas de movimientos reales es costoso, requiere mucho tiempo y es difícil de escalar. Los datos de videojuegos ya existen. En cantidades masivas.
Me recuerda a cómo ImageNet en su momento resolvió un problema similar: no inventando nueva tecnología, sino recopilando e estructurando sistemáticamente datos que ya existían. El efecto fue revolucionario.
¿Qué sucede ahora?
La pregunta de seguimiento natural es, por supuesto, cuán bien los mundos simulados de videojuegos pueden realmente enseñar a una IA a manejar la realidad desordenada e impredecible. Es una objeción legítima. La transición del entrenamiento digital a la aplicación física — lo que los investigadores llaman el problema sim-to-real — es bien conocida y compleja.
Pero la dirección es clara. Y en una industria donde el acceso a los datos de entrenamiento correctos suele ser el cuello de botella decisivo, la capacidad de identificar y licenciar fuentes de datos no aprovechadas es una ventaja competitiva estratégica de primer rango. Worldmodeldata ha encontrado una mina de oro en un lugar inesperado — en millones de horas de juego que de otro modo nunca habrían servido para un propósito mayor.