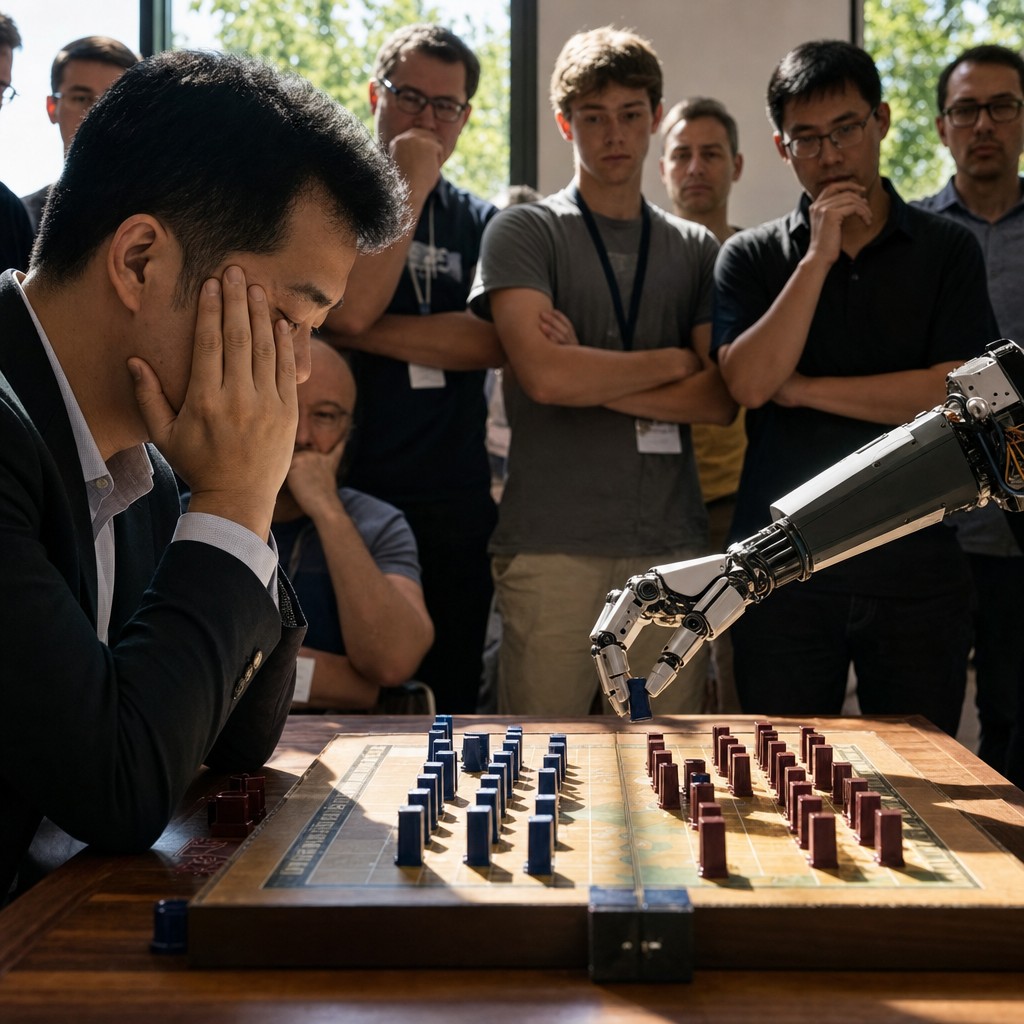
La IA aplasta al campeón mundial en Stratego – el último gran juego con piezas ocultas que resistió a las máquinas
La IA derrota al campeón mundial en Stratego – el último gran juego que resistió a las máquinas.
El último baluarte cae
El ajedrez cayó en 1997. Go cayó en 2016. El póker ha sido durante mucho tiempo un problema resuelto. Pero Stratego – el aparentemente sencillo juego de mesa con soldados, minas y piezas ocultas – ha resistido tenazmente. Hasta ahora.
Un equipo de investigadores de Carnegie Mellon, MIT, New York University y Stanford ha construido el sistema Ataraxos, que según Ars Technica derrotó a Pim Niemeijer – ampliamente considerado el mejor jugador de Stratego del mundo – con un resultado aplastante de 15–1, con cuatro partidas empatadas. Lo que hace que la victoria sea especialmente notable es el presupuesto: el entrenamiento requirió solo 16 tarjetas gráficas y costó algunos miles de dólares. Una cantidad ridículamente pequeña comparada con lo que, por ejemplo, DeepMind gastó en sus intentos anteriores fallidos.
Pero ¿por qué Stratego ha sido tan difícil? Se trata de información incompleta – exactamente como en el póker. Las 40 piezas del oponente permanecen ocultas hasta que entran en combate, lo que crea un espacio de búsqueda astronómico de más de un decillón de configuraciones posibles. Las partidas pueden durar hasta 2 000 movimientos. Y luego está el bluff: una pieza débil puede moverse como si fuera la más fuerte para asustar al oponente. Si nunca bluffeas, te vuelves predecible. Si bluffeas demasiado, las amenazas pierden efectividad. Es un equilibrio que los sistemas anteriores nunca dominaron realmente.
Ataraxos lo resolvió modelando activamente las piezas ocultas del oponente – y adaptando su estrategia de bluff en consecuencia. Es un avance genuino, no solo para los juegos, sino para cómo la IA maneja información incompleta y oculta.
Predicciones sin entrenamiento – ¿es posible?
En paralelo con el triunfo de Stratego, NVIDIA lanza algo que a primera vista parece casi imposible: un modelo de IA para datos tabulares que hace predicciones sin necesidad de ser entrenado con tus datos.
El modelo se llama Kumo Tabular y viene en tres tamaños, de 28 a 215 millones de parámetros. Está preentrenado exclusivamente en tablas artificiales y maneja clasificación y regresión en un único paso de cálculo – sin ajuste fino, sin requerir adaptación de los datos de entrada. ¿Valores faltantes? Se manejan automáticamente.
Según MarkTechPost, Kumo Tabular se posiciona en la parte superior en varios puntos de referencia independientes y se reporta que es 17 veces más rápido que su competidor LimiX-2 en una única unidad de procesamiento gráfico. El modelo se distribuye bajo la licencia OpenMDW-1.1, que permite el uso comercial – una opción deliberada que lo distingue de competidores con condiciones no comerciales.
Para quienes trabajamos en desarrollo de sistemas impulsados por datos, esto es importante. Los datos tabulares siguen siendo el tipo de dato más común en sistemas empresariales, y tradicionalmente han requerido una manipulación manual significativa y entrenamiento específico del dominio para cada nuevo caso de uso. Si Kumo Tabular cumple lo que promete en entornos de producción reales, podría reducir dramáticamente la barrera para el análisis predictivo.
Mejores respuestas – y las pruebas que las respaldan
La tercera pieza del rompecabezas viene de Perplexity, que junto con turbobuffer ha lanzado el modelo de incrustación pplx-embed-v2-context-9b-preview. Está construido para sistemas RAG – es decir, sistemas que combinan recuperación de información con texto generativo – pero con una diferencia importante respecto a las soluciones tradicionales.
En lugar de simplemente devolver el fragmento de texto más probable, el modelo también recupera el contexto circundante necesario para verificar la respuesta. El método de entrenamiento también es innovador: en lugar de etiquetas binarias burdas, se utiliza un modelo maestro que puntúa cada unidad de lenguaje individual, proporcionando objetivos de entrenamiento más suaves y matizados.
Los resultados son convincentes según MarkTechPost – precisión de respuesta del 45,5 por ciento en diez resultados recuperados en el punto de referencia interno context-bench, todo 14,4 puntos porcentuales mejor que el competidor más cercano. Los pesos del modelo están disponibles públicamente en Hugging Face bajo la licencia MIT.
Tres noticias – un patrón
Si se leen estas tres noticias por separado, parecen avances separados en investigación de juegos, aprendizaje automático y recuperación de información. Pero si se amplía la vista, emerge un patrón más claro: los sistemas de IA se vuelven cada vez mejores para generalizar – para manejar situaciones para las que no fueron entrenados explícitamente, para navegar información oculta, para funcionar sin conjuntos de datos personalizados.
Ataraxos maneja piezas invisibles. Kumo Tabular predice sin entrenamiento específico del dominio. El modelo de Perplexity no solo recupera respuestas sino también su contexto. Ya no se trata únicamente de un mejor desempeño en tareas bien definidas – se trata de manejar el desorden de la realidad.