La IA convierte fotos en entornos tridimensionales, pero no puede evaluar sus propios resultados
Un nuevo método convierte fotos corrientes en entornos tridimensionales editables en código de programación.
De la fotografía a la escena 3D, a través del código
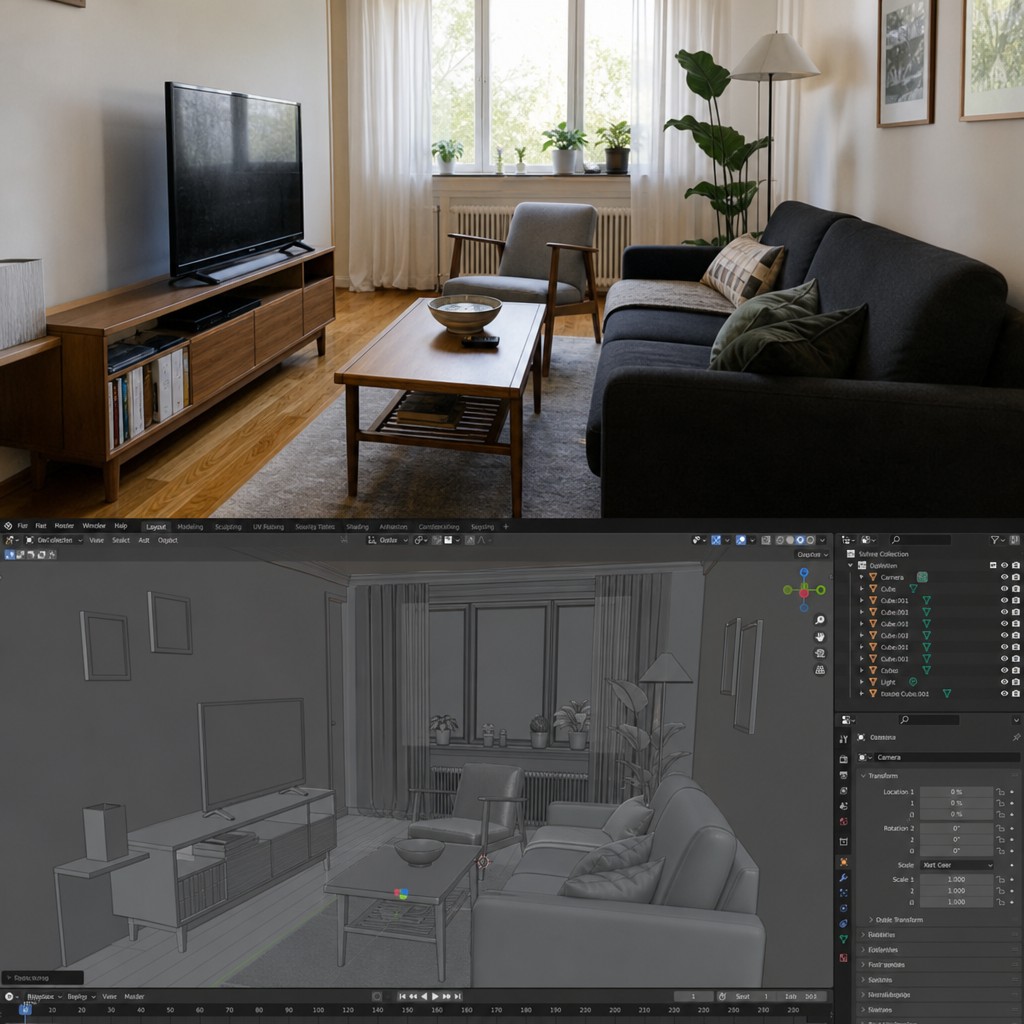
Imagina que haces una foto de tu sala de estar, la introduces en un sistema de IA y recibes a cambio una escena tridimensional completa y editable en Blender. No una imagen estática, sino un programa estructurado con objetos, geometría, disposición y posición de cámara, igual que cualquier otro código de programación. Esto es exactamente lo que el equipo de investigación detrás del método Image-to-Code ha logrado, según The Decoder.
El enfoque es elegante en su diseño. En lugar de intentar generar toda la escena 3D de un solo salto, el agente trabaja de forma iterativa: escribe código, lo ejecuta en Blender, revisa el resultado y lo ajusta, una y otra vez, hasta que la escena se parece lo suficiente a la fotografía original. Recuerda a la forma de trabajar de un desarrollador experimentado: no es perfecto en el primer intento, pero mejora sistemáticamente en cada vuelta del ciclo.
El hecho de que el resultado sea código, y no un archivo 3D bloqueado, es especialmente interesante desde la perspectiva del desarrollo de sistemas. Permite la editabilidad, el control de versiones y la integración en flujos de trabajo existentes de una manera que los modelos puros de generación de imágenes no pueden ofrecer.
El punto de referencia que marca el listón
Para poder medir con precisión lo bien que funcionan los métodos, el equipo de investigación creó el punto de referencia LEGO-Bench, un conjunto de pruebas con 208 imágenes de 104 entornos diferentes, tanto interiores como exteriores, con un total de 443 objetos registrados. La evaluación se realiza según tres ejes: si se entrega una escena utilizable, con qué precisión se reproduce la geometría y en qué medida el aspecto de la escena coincide con la imagen original.
Los resultados son elocuentes. Las seis configuraciones de GPT probadas lograron entregar una escena funcional en casi todos los intentos, lo cual ya es notable de por sí. Pero la precisión varía mucho. El mejor modelo, GPT-4o Astra, alcanza una precisión del 53,4 por ciento en entornos interiores y del 39,6 por ciento en entornos exteriores. Las configuraciones más débiles se quedan en torno al 15 por ciento.
Otra observación interesante: cuando el equipo de investigación aumentó el presupuesto de cómputo para el razonamiento de los modelos, los resultados mejoraron de forma notable. Esto sugiere que estos agentes no han alcanzado ningún tipo de techo: responden claramente a más recursos y a una mejor orientación.
El punto ciego: falta de autoconocimiento
Aquí llega el detalle que realmente se queda grabado. Aunque los agentes pueden producir escenas 3D aceptables, carecen de la capacidad de determinar por sí mismos si realmente han tenido éxito. No pueden decidir de forma fiable si la escena generada coincide con la fotografía original; en otras palabras, carecen de capacidad metacognitiva.
Esto no es un pequeño detalle técnico. Es una limitación fundamental que afecta a cómo pueden utilizarse estos sistemas en la práctica. Hoy en día, determinar si el resultado cumple los requisitos exige revisión humana. El agente puede iterar y mejorar, pero no sabe cuándo ha terminado, ni si siquiera si va por el buen camino.
Como desarrollador de sistemas, reconozco el patrón. Recuerda a las primeras versiones de las herramientas automatizadas de pruebas, que podían ejecutar tests pero no comprender lo que significaba un test fallido en un contexto más amplio. Las herramientas eran potentes, pero el juicio crítico seguía siendo humano.
Capacidad impresionante, con límites claros
Sería fácil tanto exagerar como subestimar lo que aquí se muestra. Por un lado, que un agente de IA pueda tomar una sola fotografía y generar una escena 3D estructurada y editable en una herramienta profesional como Blender es genuinamente asombroso. Hace apenas unos años, esto habría requerido un equipo de especialistas y semanas de trabajo.
Por otro lado, una precisión del 53 por ciento en la mejor configuración, combinada con un agente que no puede evaluar sus propios resultados, nos recuerda que todavía nos encontramos en una fase temprana. Estos sistemas son herramientas potentes que necesitan usuarios competentes, no sustitutos autónomos de la experiencia humana.
Es precisamente esa combinación lo que hace que este campo sea tan fascinante de seguir en este momento.