El nuevo modelo de incrustación de Google maneja texto, imagen, video y audio, y cabe en tu teléfono
Google DeepMind ha lanzado EmbeddingGemma 2, un modelo de incrustación abierto y versátil que convierte texto, código, imágenes, video y audio en un sistema de representación común. El modelo está diseñado para ejecutarse directamente en tu dispositivo, sin servicios en la nube como intermediario, y en su forma más sencilla necesita apenas unos 200 megabytes de memoria de trabajo. Esto lo convierte en una herramienta inusualmente accesible para los desarrolladores que quieren trabajar con varios tipos de datos en un mismo sistema.
Una comprensión común para todo
Imagina que buscas en un archivo de imágenes con una consulta de texto, o que tu aplicación puede comparar un clip de audio con una descripción de texto, sin que tengas que construir sistemas separados para cada modalidad. Es la promesa central de EmbeddingGemma 2, que Google DeepMind lanzó recientemente y que, según informa MarkTechPost.
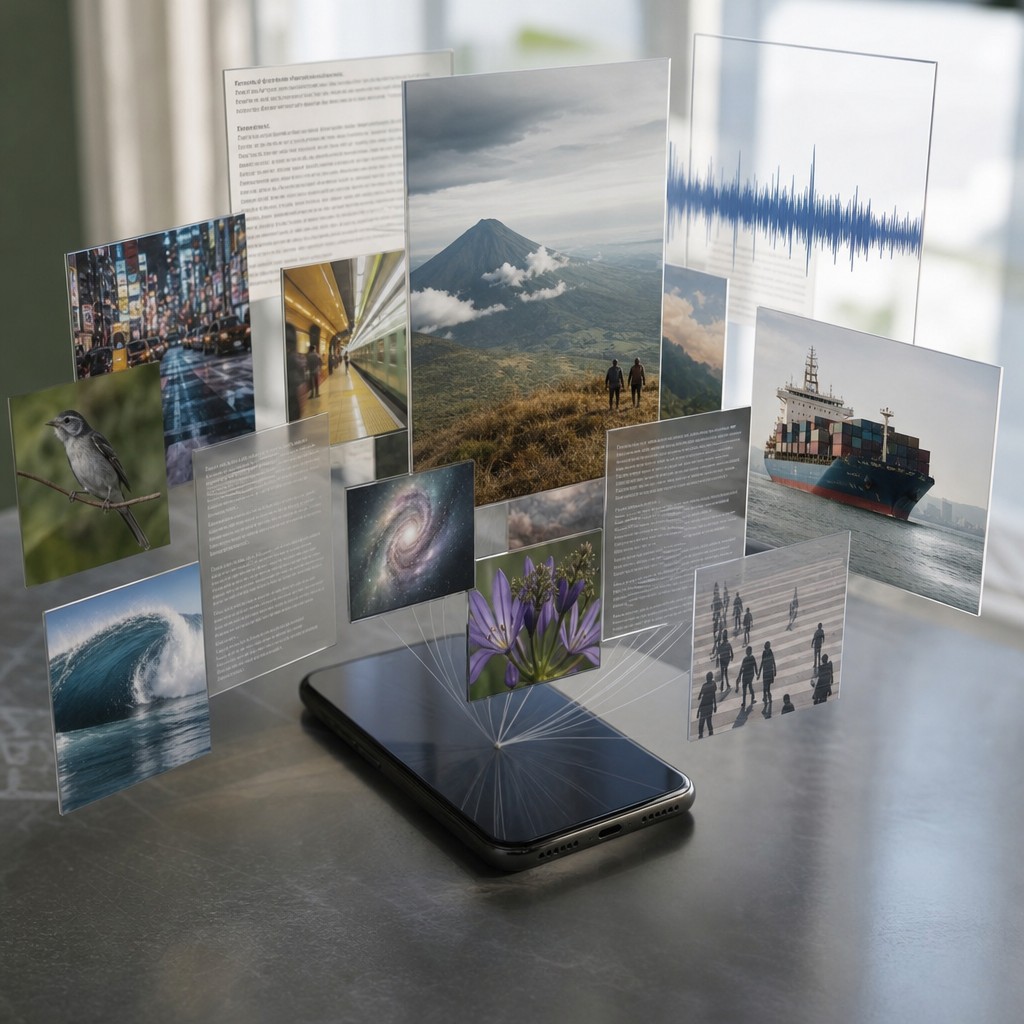
El modelo está construido sobre la arquitectura Gemma 4 y puede convertir texto, código, imágenes, video y audio en un espacio vectorial de 768 dimensiones común. El significado técnico es elegante: ya sea que la entrada sea una fotografía o un fragmento de código, termina en el mismo formato de representación, lo que permite comparar y buscar entre modalidades de forma natural.
En la práctica, es justamente esa capacidad la que durante mucho tiempo ha requerido soluciones de pipeline costosas y complejas, con modelos especializados separados para cada tipo de datos. Ahora todo se reúne en un solo paquete.
El tamaño importa, y en la dirección correcta
Lo que realmente llama mi atención como desarrollador son las especificaciones técnicas. El modelo es modular y escalable: el uso solo de texto requiere únicamente 270 millones de parámetros, mientras que el soporte multimodal completo llega hasta 740 millones de parámetros. Con cuantización, la versión de texto necesita aproximadamente 191 MB de memoria de trabajo, y la versión multimodal completa alrededor de 567 MB, medido en un Pixel 11 Pro.
Son cifras que realmente importan. Hablamos de un modelo que cabe en la memoria libre de un teléfono moderno sin que haya que sacrificar toda la experiencia de la aplicación. Para quien ha seguido la tendencia hacia modelos cada vez más pesados en los últimos años, esto es un movimiento bienvenido en la dirección opuesta.
Además, la ventana de contexto de 8 192 símbolos es cuatro veces mayor que la del modelo anterior, lo que en la práctica significa que el modelo puede procesar, por ejemplo, 5,5 minutos de audio o 29 imágenes en una sola llamada. Esto abre casos de uso muy interesantes en búsqueda, clasificación y análisis semántico de contenido más largo.
Código abierto y un ecosistema familiar
Un detalle que no debe subestimarse: el modelo se publica bajo la licencia Apache 2.0 y está disponible a través de Hugging Face y Kaggle. Es compatible con herramientas como Ollama y llama.cpp, es decir, precisamente el ecosistema que ya usan muchos desarrolladores independientes y equipos pequeños.
Es una decisión deliberada de Google DeepMind. No basta con lanzar un modelo; encontrarse con los desarrolladores allí donde realmente están reduce drásticamente la barrera de entrada. No hace falta reescribir la infraestructura: se puede empezar a experimentar con las herramientas existentes.
¿Qué significa esto para los desarrolladores de aplicaciones?
En términos concretos, EmbeddingGemma 2 abre la puerta a varios tipos de funciones que antes eran difíciles de construir sin servicios en la nube:
- Búsqueda semántica entre texto e imágenes en bases de datos locales
- Clasificación de contenido de tipos de medios mixtos directamente en el dispositivo
- Análisis de similitud que puede comparar un clip de audio con una descripción de texto
- Funciones de IA con capacidad offline, sin depender de una conexión de red
El último punto quizá sea el más subestimado. Las aplicaciones sensibles a la integridad, como las de salud, las aplicaciones de notas o un archivo de documentos local, ahora pueden beneficiarse de la IA multimodal sin que los datos salgan nunca del dispositivo. No es poca cosa.
Hemos visto una clara tendencia en la industria hacia lo que a veces se denomina edge AI (IA de borde), es decir, IA que se ejecuta en el propio dispositivo en lugar de en un centro de datos. EmbeddingGemma 2 es un paso claro en esa dirección, y la calidad técnica de la implementación parece prometedora.
Como desarrollador de sistemas, veo esto como exactamente el tipo de bloque de construcción que faltaba: un modelo bien definido, abierto y lo bastante pequeño como para incrustarse de verdad en un producto real sin requerir un clúster de servidores propio.