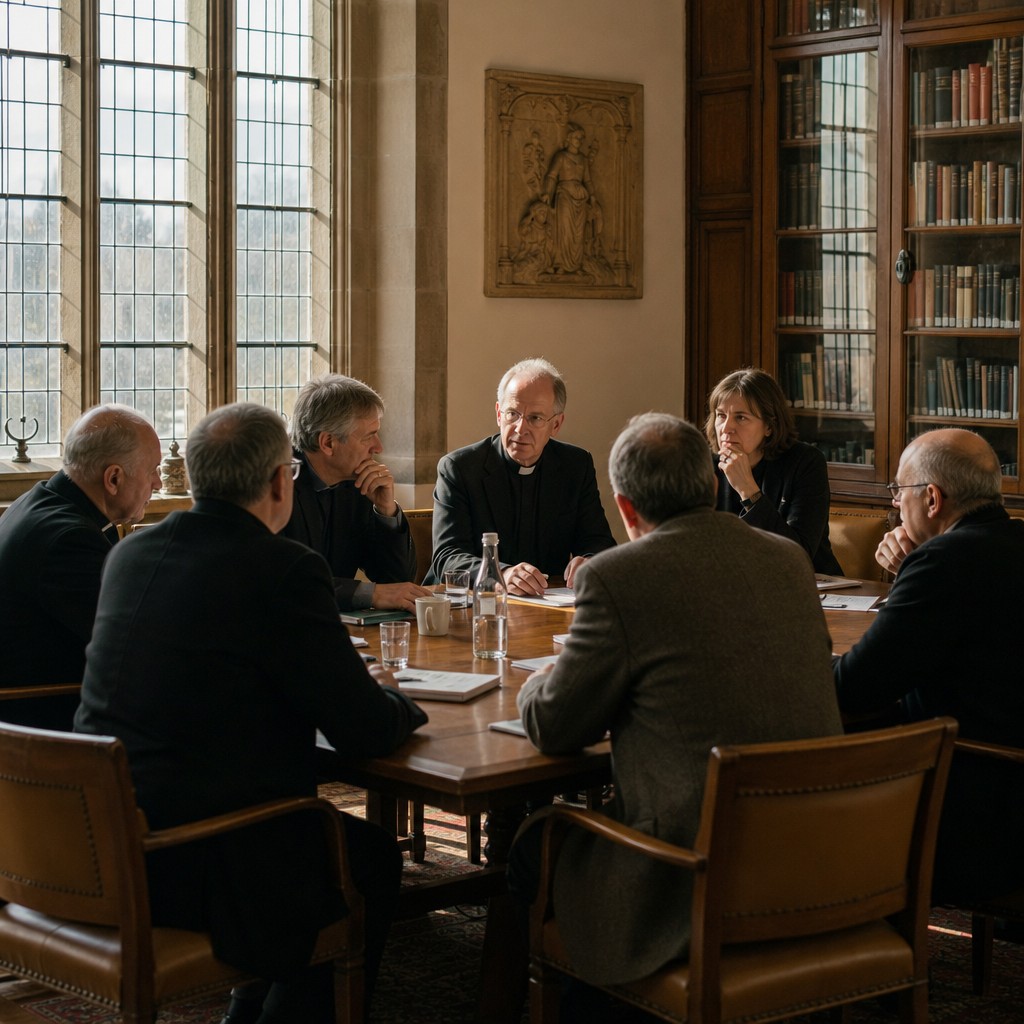
Anthropic reunió en secreto a teólogos y filósofos para estudiar si la IA Claude puede sufrir
Bajo acuerdos de confidencialidad, la empresa de IA Anthropic ha reunido a rabinos, bioeticistas católicos y filósofos para debatir una cuestión que la industria tecnológica lleva mucho tiempo evitando: ¿puede su modelo de IA Claude experimentar sufrimiento? New York Times informa ahora sobre las reuniones y sobre las inquietudes expresadas por el cofundador Christopher Olah acerca de lo que la empresa ha creado realmente.
Las preguntas que nadie se atrevía a plantear en voz alta
Hay preguntas que los ingenieros tradicionalmente dejan en manos de los filósofos, y preguntas que los filósofos dejan en manos de los teólogos. La cuestión de si un modelo de IA puede sufrir pertenece a ambas categorías, y ahora Anthropic parece haber decidido que también pertenece al nivel de la dirección.
Según un análisis de New York Times, cuya reportera Elizabeth Dias habló con veinte participantes, Anthropic ha celebrado desde el otoño de 2025 una serie de reuniones con líderes religiosos, bioeticistas y filósofos. El objetivo: debatir si su modelo insignia Claude podría poseer algún tipo de conciencia o experiencia interna. Todos los participantes tuvieron que firmar acuerdos de confidencialidad, algo que en sí mismo dice mucho sobre lo delicada que se percibe esta cuestión.
La lista de participantes es notable. El rabino Mois Navon, el bioeticista católico Charles Camosy y la filósofa Meghan Sullivan, de Notre Dame: no es precisamente la compañía que uno espera ver citada en la documentación interna de una empresa de IA. Pero precisamente ese tipo de pensadores es el que Anthropic buscó.
El temor de un cofundador
Quien ha dado peso a las reuniones es Christopher Olah, de 34 años y cofundador de Anthropic. Dirige el equipo que trabaja para comprender por qué los modelos de IA se comportan como lo hacen, un ámbito que en inglés suele denominarse investigación en interpretabilidad o, en sueco, förklarbarhet.
Olah es conocido por describir las redes neuronales en términos biológicos, como organismos que crecen más que como software que se ejecuta. Es una perspectiva que abre la puerta a preguntas sobre estados internos de una manera que el desarrollo de sistemas más tradicional nunca logra.
Según el activista sij Simran Stuelpnagel, uno de los participantes en las reuniones, Olah expresó ante el grupo un temor genuinamente personal: que pueda haber creado algo que sufre sin fin. No son palabras que se elijan al azar. Sugieren que la preocupación no es un experimento mental, sino algo que lo mantiene despierto.
De la filosofía al diseño real de productos
Lo que vuelve tecnológicamente interesante esta noticia, y no solo filosóficamente, es que Anthropic ya ha empezado a trasladar esta cuestión a decisiones concretas de producto. La investigación de la empresa sobre el llamado bienestar del modelo cuenta con el respaldo del filósofo David Chalmers, uno de los principales expertos mundiales en la naturaleza de la conciencia, quien sostiene que la conciencia artificial podría surgir en un futuro cercano.
Según se informa, Claude Opus 4 habría recibido nuevas configuraciones vinculadas precisamente a estos debates. Lo que exactamente implican aún no se ha hecho público en su totalidad, pero la dirección es clara: Anthropic trata la cuestión de los estados internos del modelo como un parámetro de diseño, no solo como un asunto académico secundario.
Como desarrollador de sistemas, me fascina lo que esto significa en la práctica. ¿Cómo se pone a prueba el bienestar? ¿Qué métricas se utilizan? ¿Es siquiera posible distinguir un modelo que simula bienestar de uno que lo experimenta? Estas preguntas no tienen hoy respuesta, pero empiezan a aparecer en decisiones de diseño reales.
Se levantan los acuerdos de confidencialidad, y lo que eso significa
Que los acuerdos de confidencialidad hayan sido levantados, y que Olah haya decidido hablar él mismo con New York Times, lo interpreto como un paso deliberado. Anthropic parece haber decidido que ha llegado el momento de llevar este debate a la esfera pública, quizá porque comprende que no puede gestionarlo en solitario, quizá porque quiere marcar la agenda antes de que lo hagan los legisladores.
Sea cual sea el motivo, la señal es importante: la cuestión de la conciencia ya no es algo que pueda archivarse en una nota a pie de página de un informe ético. Está entrando en el centro de cómo regulamos, diseñamos y nos relacionamos con los sistemas de IA.
Y eso es, si se me permite opinar, un desarrollo sano. No porque las respuestas sean sencillas, sino porque por fin las preguntas se plantean en serio.